Das Siddata-Projekt (Studienindividualisierung durch digitale, datengestützte Assistenten) war ein interdisziplinäres Forschungsprojekt, das untersuchte, wie Studierende mithilfe eines datengestützten Studienassistenten bei der Verfolgung ihrer individuellen Bildungsziele unterstützt werden können. Das Projekt wurde gemeinsam von den Universitäten Osnabrück, Hannover und Bremen sowie dem HIS-Institut für Hochschulentwicklung durchgeführt und vom Bundesministerium für Bildung und Forschung (BMBF) gefördert.
Das interdisziplinäre SIDDATA-Projekt untersucht, wie Studierende bei der Erreichung individueller Bildungsziele unterstützt werden können. Dazu werden bislang unverknüpfte Daten und Informationen in einem digitalen Studienassistenten zusammengeführt und für die eigenverantwortliche Nutzung aufbereitet. Studierende können den Assistenten flexibel nutzen und dabei individuell festlegen, welche Faktoren und Datenquellen berücksichtigt werden sollen. Zu den verwendbaren Daten zählen Daten aus Lernmanagementsystemen, Angebote und Ressourcen anderer Hochschulen und Institutionen und Daten zum individuellen Lern- und Arbeitsverhalten.
Mit der Nutzung des Assistenten sollen Studierende ermutigt werden, eigene Bildungsziele zu definieren und konsequent zu verfolgen. Die datengestützte Umgebung soll damit künftig in der Lage sein, situationsadäquat Hinweise, Erinnerungen und Empfehlungen zu geben und dabei lokale als auch extern angebotene Lehrveranstaltungen und Open Educational Resources (OER) miteinzubeziehen. Diese Hinweise und Empfehlungen sollen Studierenden helfen, informierte Entscheidungen für den eigenen individuellen Bildungsweg zu treffen. [1]https://www.siddata.de/
Die Idee war, Informationen aus verschiedenen Quellen wie Vorlesungsverzeichnissen, Lernmanagementsystemen und individuellen Interessen der Studierenden zusammenzuführen, um personalisierte Empfehlungen zu ermöglichen. Statt sich ausschließlich am regulären Studienverlaufsplan zu orientieren, sollten Studierende auch Veranstaltungen außerhalb ihres eigenen Studiengangs entdecken, passende Lernmaterialien finden, sich mit anderen Studierenden vernetzen und Unterstützung bei der Studienplanung erhalten können.
Der Assistent wurde in Stud.IP integriert, dem Lernmanagementsystem, das an allen drei beteiligten Universitäten eingesetzt wurde, und im Laufe des Projekts von mehr als 3.000 Studierenden getestet.
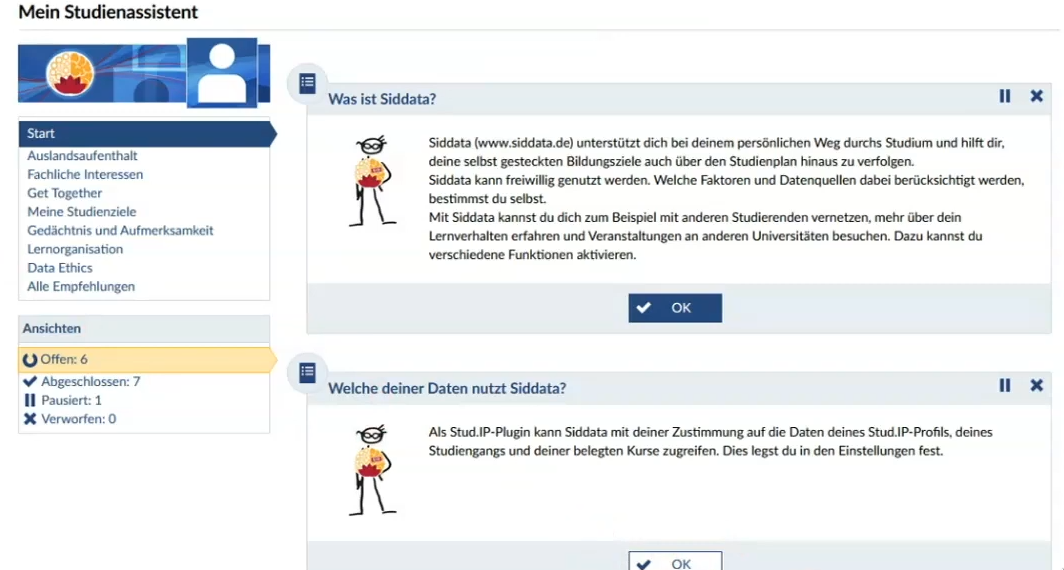
Der Studienassistent
Der Assistent besteht aus einem Stud.IP-Plugin, das die Benutzeroberfläche bereitstellt, und einem zentralen Python/Django-Backend, die über eine REST-API miteinander kommunizieren. Das Backend sammelt, verarbeitet und verknüpft Daten der verschiedenen Universitäten, verwaltet individuelle Studienziele und generiert personalisierte Empfehlungen.
Die Funktionalität ist in unabhängige Recommender-Module aufgeteilt, die Studierende je nach ihren Interessen und Bedürfnissen aktivieren können. Dazu gehören unter anderem:
- Fachliche Interessen: Studierende beschreiben ihre Interessen in natürlicher Sprache und erhalten Empfehlungen für passende Lehrveranstaltungen, auch an anderen Hochschulen, sowie MOOCs und Open Educational Resources (OER). Mithilfe von Machine Learning werden die Inhalte der Angebote semantisch abgeglichen, statt lediglich nach übereinstimmenden Schlüsselwörtern zu suchen.
- Get Together: Vernetzt Studierende mit ähnlichen Interessen, Lehrveranstaltungen oder Plänen, beispielsweise um Lernpartner zu finden oder Erfahrungen zu Auslandsaufenthalten auszutauschen.
- Auslandsaufenthalt: Unterstützt Studierende bei der Planung eines Auslandssemesters, unter anderem durch Informationen und Erinnerungen zu den verschiedenen Phasen des Bewerbungsprozesses.
- Meine Studienziele: Ermöglicht Studierenden, individuelle Studienziele zu definieren, zu organisieren und deren Fortschritt zu verfolgen.
- Persönlichkeit: Nutzt psychologische Fragebögen, um die Selbstreflexion anzuregen und Informationen über individuelle Lernstrategien bereitzustellen.
Ein wichtiger Aspekt des Konzepts war, dass Studierende selbst entscheiden können, welche Module sie verwenden und welche persönlichen Daten sie dafür freigeben möchten. Das Backend arbeitet mit pseudonymisierten Nutzerdaten. Die einzelnen Recommender verwenden dabei unterschiedliche Ansätze, von einfachen Regeln und Fragebögen bis hin zu Machine-Learning-basiertem semantischem Matching.
Ein Beispiel für Letzteres ist SidBERT, ein BERT-basiertes NLP-Modell, das Bildungsressourcen anhand ihrer Titel und Beschreibungen verschiedenen Wissensgebieten zuordnet. Dafür wurde es auf Basis der Dewey-Dezimalklassifikation (DDC) trainiert, einem Klassifikationssystem, das unter anderem in Bibliotheken verwendet wird. Dasselbe Modell kann auch die frei formulierten Interessen eines Studierenden kategorisieren. So kann das System Lehrveranstaltungen und Lernmaterialien aus verwandten Wissensgebieten identifizieren.
Mein Beitrag
Ich habe als studentische Hilfskraft an der Universität Osnabrück am Siddata-Projekt gearbeitet. Zu meinen Aufgaben gehörten die Entwicklung von Machine-Learning-Recommendern zur Empfehlung von Lehrveranstaltungen und anderen Bildungsressourcen, die Weiterentwicklung des Django-Backends sowie die Betreuung der für den Betrieb notwendigen Infrastruktur.
Ein wesentlicher Teil meiner Arbeit bestand schließlich darin, den bestehenden Forschungsprototypen in eine wartbare, getestete und einfach deploybare Software zu verwandeln.
Wie bei Forschungssoftware nicht unüblich, lag der ursprüngliche Fokus vor allem auf der Implementierung neuer Features und dem Experimentieren mit verschiedenen Ansätzen, weniger auf langfristiger Wartbarkeit. Im Laufe der Zeit war daraus ein recht komplexes System mit zahlreichen Abhängigkeiten, mehreren miteinander kommunizierenden Services und einem zunehmend aufwendigen Einrichtungsprozess geworden.
Das Deployment einer neuen Instanz konnte rund drei Tage dauern, da Abhängigkeiten manuell installiert, Services konfiguriert und die verschiedenen Komponenten miteinander zum Laufen gebracht werden mussten. Das erschwerte auch neuen Entwickler*innen den Einstieg und machte es schwierig, dieselbe Umgebung auf einem anderen Rechner zu reproduzieren.
Deshalb habe ich das Backend und die zugehörige Infrastruktur umfassend überarbeitet, mit besonderem Fokus auf Codequalität, Reproduzierbarkeit, automatisierte Tests und Deployment. Konkret habe ich unter anderem an folgenden Bereichen gearbeitet:
- Machine Learning: Ich habe Machine-Learning-basierte Recommender entwickelt und implementiert, die Studierenden passende Lehrveranstaltungen und andere Bildungsressourcen empfehlen, und an der Infrastruktur für die Ausführung und Bereitstellung der Modelle gearbeitet.
- Containerisierung und Deployment: Ich habe ein Docker-Compose-Setup erstellt, das das Django-Backend, die PostgreSQL-Datenbank, TensorFlow Serving und den Webserver umfasst. Durch getrennte Konfigurationen lässt sich dasselbe Projekt sowohl in Entwicklungs- als auch in Produktionsumgebungen betreiben, ohne die einzelnen Services manuell einrichten zu müssen.
- Restrukturierung des Backends: Ich habe das Python-Projekt neu strukturiert, separate Konfigurationen für Entwicklung, Produktion und automatisierte Tests eingeführt und die Codestruktur und Wartbarkeit verbessert.
- Automatisierte Tests und Codequalität: Ich habe automatische Codeformatierung und Linting mit Black und Flake8 eingeführt, die über Pre-Commit-Hooks und GitHub Actions durchgesetzt werden. Die CI-Pipeline baut automatisch die Docker-Umgebung und führt Smoke-Tests und Health-Checks durch, einschließlich Datenbankverbindung und Migrationen.
- Datenanalyse und Visualisierung: Ich habe ein auf Plotly basierendes Analytics-Dashboard entwickelt, mit dem Forschende aggregierte Projektdaten untersuchen können, darunter die Nutzung einzelner Recommender, die Beteiligung der Studierenden und Eigenschaften der Nutzerbasis.
- Dokumentation: Ich habe Installations- und Entwicklerdokumentation für die verschiedenen Umgebungen, Entwicklungsworkflows und die containerisierte Infrastruktur erstellt.
In der Produktionsumgebung wird die Django-Anwendung über nginx und uWSGI bereitgestellt, während PostgreSQL und TensorFlow Serving in separaten Containern laufen. Docker Compose verwaltet die verschiedenen Services und ihre Abhängigkeiten. Die CI-Pipeline überprüft zusätzlich, ob die Anwendung korrekt startet und ihre wesentlichen Komponenten funktionieren.
Das Ergebnis war, dass die Einrichtung des vollständigen Backends auf einem neuen Server von einem mehrtägigen Prozess auf im Wesentlichen einen einzigen Docker-Compose-Befehl reduziert wurde, sobald Docker installiert und die notwendige Konfiguration vorhanden war. Kein stundenlanges manuelles Installieren und Konfigurieren des gesamten Software-Stacks mehr!
Forschung und Masterarbeit
Neben der Softwareentwicklung war ich auch an der wissenschaftlichen Forschung und den zugehörigen Publikationen des Projekts beteiligt. Unter anderem habe ich an einem frühen Manuskript zur Softwarearchitektur, dem modularen Recommender-Konzept und der Analytics-Infrastruktur mitgeschrieben, in dem ich auch als Co-Autor aufgeführt war. Eine spätere Version dieser Arbeit wurde 2022 unter dem Titel A Web-Based Recommendation System for Higher Education: SIDDATA - History, Architecture and Future of a Digital Data-Driven Study Assistant veröffentlicht.
Auch meine Masterarbeit zum Thema Explainable Course Recommendation habe ich im Rahmen des Siddata-Projekts geschrieben.
Die Motivation dahinter hing eng mit den Herausforderungen des Studienassistenten zusammen: Wie können wir Bildungsressourcen auf Grundlage ihrer Inhalte empfehlen und gleichzeitig dafür sorgen, dass die Empfehlungen für Studierende nachvollziehbar sind?
Klassische Embedding-Modelle können semantische Ähnlichkeiten zwischen Texten repräsentieren, allerdings sind die einzelnen Dimensionen ihrer Vektorräume in der Regel nicht interpretierbar. In meiner Masterarbeit habe ich deshalb einen anderen Ansatz auf Basis von Conceptual Spaces untersucht, bei dem die Dimensionen bedeutungsvolle semantische Eigenschaften repräsentieren.
Anhand von Beschreibungen universitärer Lehrveranstaltungen habe ich eine Pipeline entwickelt, mit der sich ein solcher Raum direkt aus den Daten ableiten lässt. Ziel war es, erklärbare Empfehlungen zu ermöglichen. Statt Lehrveranstaltungen einfach nur deshalb vorzuschlagen, weil sie etwas ähneln, das einem Studierenden bereits gefällt, könnte das System erklären, in welcher Hinsicht sich die Veranstaltungen ähneln. Studierende könnten außerdem explizite Präferenzen entlang bestimmter Dimensionen angeben, beispielsweise wie mathematisch oder theoretisch eine Veranstaltung sein soll.
Dafür habe ich eine skalierbare Machine-Learning-Pipeline mit Python und Snakemake implementiert, die auf dem Rechencluster der Universität ausgeführt wurde. Die Ergebnisse deuteten darauf hin, dass die generierten Repräsentationen interpretierbare semantische Eigenschaften der Lehrveranstaltungen abbilden und damit eine vielversprechende Grundlage für transparentere Empfehlungssysteme bieten.
Mehr zur Methodik, Implementierung und den Ergebnissen gibt es im separaten Portfolioeintrag zu meiner Masterarbeit.
Links
- Siddata-Projekt - Die offizielle Projektwebsite.
- Siddata-Backend - Das Open-Source-Django-Backend mit den Recommender-Modulen und dem Analytics-Dashboard.
- Meine Docker- und Infrastrukturimplementierung - Mein containerisiertes Backend-Setup inklusive automatisierter Tests und Dokumentation.
- Stud.IP-Frontend - Das Frontend-Plugin zur Integration des Assistenten in Stud.IP.
- Meine Masterarbeit: Explainable Course Recommendation - Forschung zu interpretierbaren Embeddings von Bildungsressourcen für erklärbare Empfehlungen.
- A Web-Based Recommendation System for Higher Education: SIDDATA - Wissenschaftliche Publikation zur Architektur und Funktionalität des Projekts.