Ein Hinweis zur zeitlichen Einordnung: Das Feld der Large Language Models entwickelt sich unglaublich schnell. Dieser Eintrag beschreibt das Projekt auf dem Stand von März 2025. Gegen Ende gehe ich kurz auf einige verwandte Entwicklungen ein, die seitdem stattgefunden haben.
Während meiner Promotionszeit in der Gruppe Intelligent Software Systems der Abteilung Intelligent and Distributed Systems am Institut für Softwaretechnologie des Deutschen Zentrums für Luft- und Raumfahrt (DLR) habe ich mich mit Large Language Models für (Research) Software Engineering beschäftigt. Mein Hauptprojekt beschäftigte sich damit, wissenschaftliche Publikationen mit ihrem Quellcode zu verknüpfen und die in einem Paper beschriebenen Methoden zu nutzen, um eine bessere Repräsentation des zugehörigen Code-Repositories zu lernen.
Die Motivation dafür kam aus einem Bereich der Softwareentwicklung, der in der Diskussion um LLMs leicht übersehen wird: bestehenden Code verstehen. Studien über die Arbeit von Softwareentwickler*innen zeigen, wie wichtig das Verstehen, Navigieren und Sammeln von Informationen neben dem eigentlichen Schreiben von Code ist.1 Benchmarks zeigen häufig beeindruckende Ergebnisse bei sogenannten Greenfield-Tasks, bei denen eine neue Implementierung anhand einer Spezifikation geschrieben wird. Das sagt allerdings wenig darüber aus, wie gut ein Tool dabei hilft, ein bestehendes Projekt zu verstehen.
Gerade in der Forschung existiert Code nie ohne Kontext: Es gibt eine zugehörige Publikation, referenzierte Methoden und Projektanträge sowie das Fachwissen der Forschenden, die den Code geschrieben haben.2 In der Praxis habe ich selbst häufig Schwierigkeiten, die in einem Paper beschriebene Methode mit dem Code zu verknüpfen, der sie tatsächlich implementiert, einschließlich all der versteckten Annahmen und kleinen Anpassungen, die dafür sorgen, dass etwas in der Praxis überhaupt funktioniert. Das knüpft auch an ein Thema an, das mich bereits in meiner Masterarbeit interessiert hat: interpretierbare Embeddings, die nicht nur abbilden, dass sich zwei Texte oder Codeabschnitte ähneln, sondern auch in welcher Hinsicht und welche Annahmen sie teilen.
Manche Dinge sind direkt aus dem Code ersichtlich, beispielsweise welcher Optimizer oder welche Data-Augmentation-Verfahren zum Training eines Modells verwendet werden. Andere werden im Paper erklärt, etwa die Wahl des Datensatzes oder die Begründung für eine bestimmte Methode. Ein Teil des Wissens ist bereits in strukturierten Datenbanken verfügbar, während andere Entscheidungen nur mit entsprechendem Fachwissen nachvollziehbar sind. Um eine Implementierung wirklich zu verstehen, muss man häufig mehrere dieser Informationsquellen zusammenbringen. Und wenn man sie auf ein anderes Problem übertragen möchte, muss man zusätzlich wissen, welche Annahmen weiterhin gelten.
Die langfristige Idee meiner Promotion war deshalb ein System, das bestehende Implementierungen und ihre Publikationen nutzt, um Forschende und Research Software Engineers genau dabei zu unterstützen. Als Eingabe stellte ich mir beispielsweise etwas in dieser Art vor:
Wir haben Methode X aus Paper A verwendet, aber statt Y haben wir Z gemacht.
Anhand einer solchen Beschreibung könnte das System verwandte Arbeiten finden und auf Annahmen oder Einschränkungen hinweisen, die überprüft werden sollten. Das ist die Grundidee von Retrieval-Augmented Generation (RAG): Einem Sprachmodell werden relevante Informationen zur Verfügung gestellt, die es bei der Beantwortung einer Frage berücksichtigen kann.3 In diesem Fall würden diese Informationen sowohl die Beschreibung einer Methode als auch ihre tatsächliche Implementierung umfassen.
Wenn beispielsweise ähnliche Implementierungen alle auf Multithreading setzen, könnte das erklären, warum eine neue Implementierung unerwartet langsam ist. Oder die Wahl einer bestimmten Loss-Funktion in einem anderen Projekt könnte relevant sein, weil dort mit ähnlich unausgewogenen Daten gearbeitet wird, obwohl das Projekt aus einem völlig anderen Forschungsgebiet stammt.
Um diese Idee mit anderen Forschungsarbeiten am DLR zu verknüpfen, habe ich ein Beispiel aus der Materialforschung verwendet: die Lokalisierung einer Rissspitze anhand gemessener Verschiebungsfelder, die durch die Analyse von Bildern eines sich verformenden Materials gewonnen werden.4
Forschende, die an einem solchen Problem arbeiten, benötigen Wissen über das Material und den Messprozess, müssen aber auch entscheiden, wie sie die Lernaufgabe formulieren, mit der geringen Anzahl relevanter Pixel umgehen und die Ergebnisse evaluieren. Ähnliche Entscheidungen tauchen auch bei anderen Bildanalyseproblemen auf. In deren Lösungen steckt potenziell nützliches Wissen, sofern man die Verbindung erkennen und herausfinden kann, welche Ansätze sich tatsächlich übertragen lassen.
Repository-Level-Embeddings
Als ersten Schritt in diese Richtung habe ich daran gearbeitet, wissenschaftliche Publikationen und ihre Implementierungen so zu repräsentieren, dass sie anhand ihrer Inhalte miteinander abgeglichen werden können.
Ein Embedding ist eine numerische Repräsentation von etwas, in diesem Fall Text oder Code, die es einem Modell ermöglicht, verschiedene Beispiele miteinander zu vergleichen. Ziel ist es, dass Dinge mit ähnlicher Bedeutung auch ähnliche Repräsentationen erhalten.
Besonders interessant wird das, wenn Code und Text in einen gemeinsamen Vektorraum eingebettet werden, sodass eine Beschreibung wie „Implementiere Quicksort in Python“ im latenten Raum nahe bei einer Funktion liegt, die genau das tut.5 Dadurch lässt sich aus einer abstrakten Aufgabenbeschreibung direkt der passende Code finden.
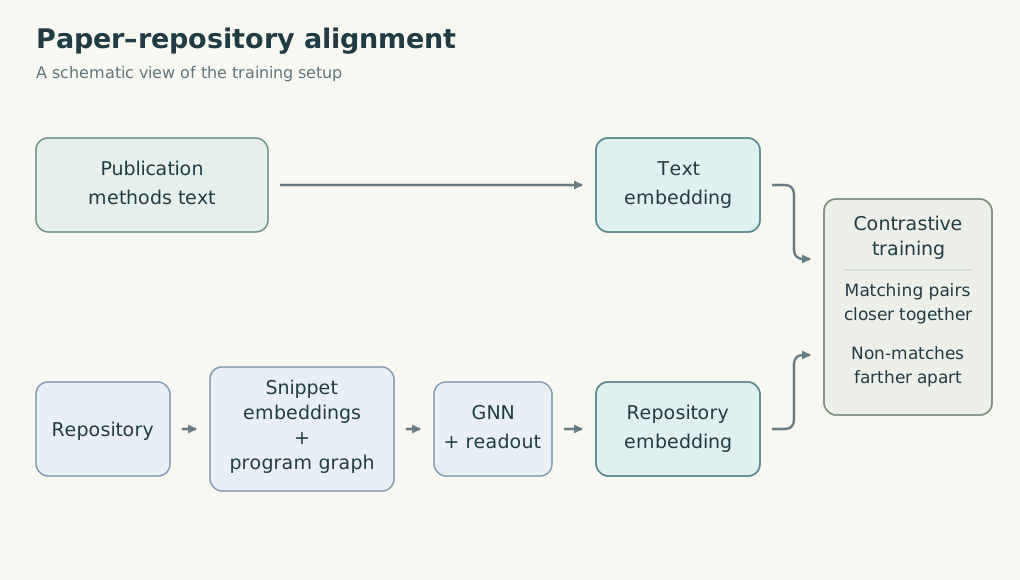
Die Idee in einem Bild: Das Paper dient als Trainingssignal, um eine Repräsentation des gesamten Repositories zu lernen. Die Abbildung zeigt schematisch den Ansatz, kein experimentelles Ergebnis.
Eine einzelne Funktion zu finden, ist allerdings etwas völlig anderes, als ein ganzes Forschungsprojekt zu repräsentieren. Ein Repository enthält neben dem eigentlichen Algorithmus auch Preprocessing, Evaluation, Hilfsfunktionen und Code zur Durchführung verschiedener Experimente. Für meine Arbeit wollte ich eine Repräsentation entwickeln, welche die vom gesamten Projekt implementierte Methode abbildet.
Repository-Level-Repräsentationen gab es bereits: Rep2Vec beispielsweise kombiniert den Codeinhalt mit Beziehungen zwischen verschiedenen Repositories.6 Mein Fokus lag dagegen darauf, aus der Implementierung selbst und dem zugehörigen Paper zu lernen.
Ein naheliegender Baseline-Ansatz war, die Embeddings einzelner Codeabschnitte mit einfachen Operationen wie Mean Pooling zusammenzufassen, also ihre Vektoren schlicht zu mitteln.
Diese Embeddings einfach zu mitteln, erschien mir allerdings nicht besonders sinnvoll. Erste Vergleiche zeigten, dass es einen Unterschied macht, ob man eine vollständige Quelldatei direkt embeddet oder die Embeddings ihrer Bestandteile aggregiert. Ebenso unterscheidet sich die Repräsentation eines Entry-Points von der des gesamten Codebestands.
Wenn alle Teile gleich gewichtet werden, kann der Beitrag des Codes, der die eigentlich interessante Methode implementiert, in der Gesamt repräsentation untergehen. Eine große Menge an Hilfscode sollte schließlich nicht allein deshalb wichtiger werden, weil es mehr davon gibt!
Meine Idee war deshalb, zu lernen, wie diese einzelnen Bestandteile sinnvoll kombiniert werden sollten, und dabei das zugehörige Paper als übergeordnete Beschreibung dessen zu verwenden, was der Code eigentlich macht.
Insbesondere der Methodenteil einer wissenschaftlichen Publikation sollte den Kern der Implementierung beschreiben, ohne dabei jede einzelne Hilfsfunktion erklären zu müssen. Dieser Ansatz beruht allerdings auf der Annahme, dass das Paper den tatsächlichen Code korrekt widerspiegelt, was nicht bei jedem Paper-Repository-Paar automatisch der Fall ist.
Wo diese Übereinstimmung gegeben ist, liefert die Publikation jedoch ein nützliches Trainingssignal: Sie beschreibt, welche Aspekte für die Repräsentation des Repositories relevant sein sollten.
Lernen aus Publikationen und Code
Ich habe einen Datensatz aus wissenschaftlichen Publikationen und den jeweils verlinkten Quellcode-Repositories zusammengestellt, ausgehend von PapersWithCode.
Aus diesen Verknüpfungen einen brauchbaren Datensatz zu erstellen, brachte einige praktische Einschränkungen mit sich: Ich konzentrierte mich auf Python-Repositories, benötigte Publikationen mit einem identifizierbaren Methodenteil und musste die Größe der Codebasen begrenzen. Auch beim Herunterladen und Parsen der Publikationen und Repositories gab es zahlreiche Sonderfälle zu berücksichtigen.
Selbst mit diesen Einschränkungen benötigten die ersten rund 30.000 gesammelten Beispiele etwa ein halbes Terabyte Speicherplatz. Ein Link zwischen einem Paper und einem Repository war zwar ein guter Ausgangspunkt, aber bis daraus tatsächlich verwendbare Eingabedaten für ein Modell wurden, war noch einiges an Arbeit nötig.
Für die Repräsentation des Codes habe ich eine Graphstruktur auf Basis des Abstract Syntax Tree (AST) entwickelt, ergänzt um Informationen über Funktionsaufrufe und Datenflüsse.
Diese Struktur beschreibt den Aufbau des Programms und die Beziehungen zwischen seinen Bestandteilen: Welche Funktionen gehören zu welchen Dateien, welche Funktionen rufen andere auf und wie bewegen sich Daten durch den Code?
Die einzelnen Codeabschnitte habe ich zunächst in Embeddings umgewandelt und anschließend ein Graph Neural Network (GNN) verwendet, um diese zu einem gemeinsamen Repository-Level-Embedding zu aggregieren.
Der Graph ermöglicht es, Informationen zwischen miteinander verbundenen Codeabschnitten auszutauschen, sodass die Repräsentation einer Funktion ihren Kontext berücksichtigen kann. Gleichzeitig kann das Modell lernen, wie stark die unterschiedlichen Bestandteile zur endgültigen Repräsentation beitragen sollten.
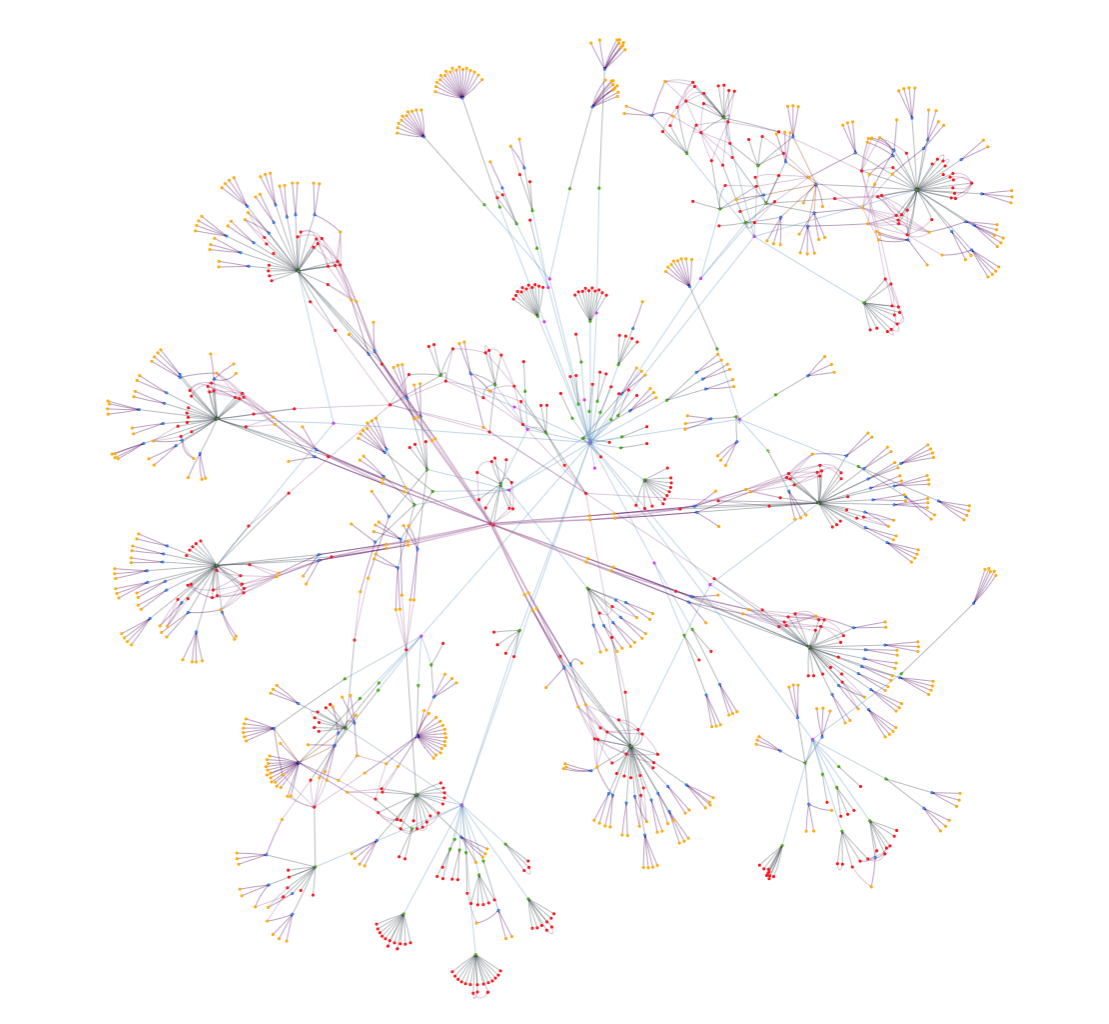
Ein Beispiel für die aus einem Repository extrahierte Graphrepräsentation. Die Knoten repräsentieren Bestandteile des Codes, während die Kanten ihre Beziehungen beschreiben. Diese Verbindungen liefern zusätzlichen Kontext bei der Kombination der einzelnen Code-Embeddings.
Dieses Modell habe ich implementiert und mithilfe von Contrastive Learning trainiert.
Dabei wird das Modell darauf optimiert, die Embeddings eines Papers und seines zugehörigen Repositories einander anzunähern, während nicht zusammengehörige Paare voneinander entfernt werden. Die bereits vorhandenen Verknüpfungen zwischen Publikationen und Repositories liefern dafür das Trainingssignal, ohne dass jemand die einzelnen Codeabschnitte manuell beschreiben und annotieren muss.
Die Repository-Repräsentation basierte dabei auf dem Code und seiner Struktur, statt auf Metadaten, die eine Zuordnung möglicherweise vereinfachen würden, ohne tatsächlich viel über die Implementierung selbst auszusagen.
Die ersten Evaluationen waren vielversprechend: Das trainierte graphbasierte Modell erzielte bessere Ergebnisse als die Pooling-Baselines.
Allerdings handelte es sich noch um frühe Experimente, bei denen es reichlich Möglichkeiten zur weiteren Optimierung des Modells und einer gründlicheren Untersuchung der Ergebnisse gab. Dennoch waren sie ein ermutigender erster Hinweis darauf, dass sich der Ansatz weiterzuverfolgen lohnen könnte.
Aus persönlichen Gründen habe ich meine Promotion beendet, bevor ich diese Arbeit weiterführen konnte. Zurück blieb ein funktionierender Forschungsprototyp.
Die übergeordnete Idee ging allerdings über den Abgleich ganzer Publikationen mit ganzen Repositories hinaus.
Ein nächster Schritt wäre gewesen, einzelne Methoden oder Module zu identifizieren, sodass Forschende beispielsweise gezielt den relevanten Preprocessing- oder Evaluationscode innerhalb eines größeren Projekts finden könnten.
Ein weiterer Ansatz, den ich untersuchen wollte, war die Kombination dieser Repräsentationen mit Informationen aus wissenschaftlichen Publikationen und Knowledge Graphs. Ansätze wie GraphRAG gehörten ebenfalls zu diesem Forschungskontext.7
Langfristig interessieren mich Repräsentationen, mit denen sich ähnliche Ansätze über verschiedene Forschungsgebiete hinweg finden lassen und die gleichzeitig erklären können, was diese Ansätze miteinander verbindet.
Einordnung der zeitlichen Entwicklung
LLMs und die dazugehörigen Tools haben sich seit diesem Projekt unglaublich schnell weiterentwickelt.
Im weiteren Verlauf des Jahres 2025 gab es mehrere verwandte Entwicklungen: GitHub stellte ein spezialisiertes Embedding-Modell vor, das die Suche nach Code und Dokumentation in Copilot verbessern soll. Gleichzeitig untersuchte cAST, wie sich Abstract Syntax Trees nutzen lassen, um Code für Retrieval-Aufgaben in sinnvollere Einheiten zu unterteilen.89
Es ist spannend zu sehen, wie gelernte Repräsentationen zunehmend Teil alltäglicher Entwicklungstools werden und gleichzeitig weiter daran geforscht wird, wie sich die Struktur von Programmen für bessere Retrieval-Verfahren nutzen lässt.
Diese Entwicklungen überschneiden sich mit Teilen meiner ursprünglichen Motivation, beschäftigen sich aber mit anderen Aufgaben.
Relevante Codeabschnitte für einen Programmierassistenten zu finden, unterscheidet sich davon, die Repräsentation einer vollständigen Forschungsimplementierung anhand ihrer zugehörigen Publikation zu lernen.
Genau diese Verbindung zwischen Paper und Implementierung und die längerfristige Möglichkeit, gemeinsame Annahmen über verschiedene Forschungsdisziplinen hinweg zu verstehen, waren die Aspekte, die mich besonders interessiert haben.
Vollständiges Abstract
Leider kann ich den Code aufgrund einer Vertraulichkeitsvereinbarung (NDA) nicht veröffentlichen. Nachfolgend findet sich eine deutsche Übersetzung des ursprünglichen Abstracts für das Paper, das ich über diese Arbeit schreiben wollte. Es dokumentiert den damaligen Stand des Projekts.
-
Roberto Minelli, Andrea Mocci und Michele Lanza, I Know What You Did Last Summer: An Investigation of How Developers Spend Their Time, ICPC, 2015. André N. Meyer et al., The Work Life of Developers: Activities, Switches and Perceived Productivity, IEEE Transactions on Software Engineering, online veröffentlicht 2017. ↩︎
-
Diane Kelly, Scientific software development viewed as knowledge acquisition: Towards understanding the development of risk-averse scientific software, Journal of Systems and Software 109, 2015, S. 50–61. ↩︎
-
Patrick Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, NeurIPS, 2020. ↩︎
-
David Melching, Tobias Strohmann, Guillermo Requena und Eric Breitbarth, Explainable machine learning for precise fatigue crack tip detection, Scientific Reports 12, 9513, 2022. Die Studie verwendet Verschiebungsfelder, die mittels digitaler Bildkorrelation gewonnen werden, und behandelt Segmentierung, Regression, Klassenungleichgewichte und Erklärbarkeit. ↩︎
-
Ye Liu et al., CodeXEmbed: A Generalist Embedding Model Family for Multiligual and Multi-task Code Retrieval, 2024. ↩︎
-
Yiyue Qian et al., Rep2Vec: Repository Embedding via Heterogeneous Graph Adversarial Contrastive Learning, KDD, 2022, S. 1390–1400. Das Modell kombiniert Codeinhalte mit Beziehungen zwischen verschiedenen Repositories. ↩︎
-
Darren Edge et al., From Local to Global: A Graph RAG Approach to Query-Focused Summarization, 2024. ↩︎
-
Shengyu Fu, GitHub Copilot gets smarter at finding your code: Inside our new embedding model, GitHub Blog, 24. September 2025. ↩︎
-
Yilin Zhang et al., cAST: Enhancing Code Retrieval-Augmented Generation with Structural Chunking via Abstract Syntax Tree, erstmals als Preprint veröffentlicht am 18. Juni 2025. ↩︎